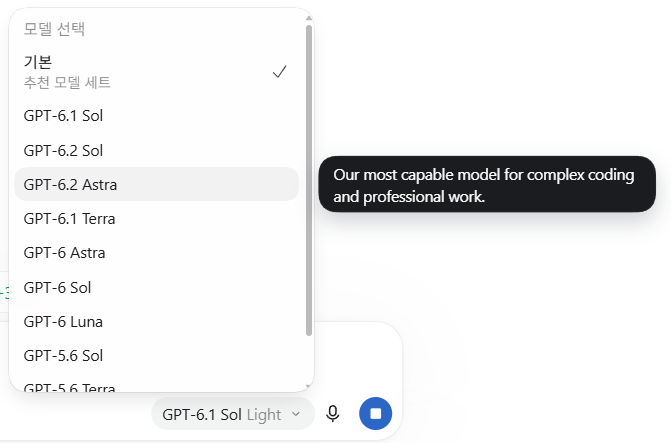
눌러보긴 겁난다. 얼마나 토큰 빨아 먹으려나
'모종의 음모 > ai 프로그램' 카테고리의 다른 글
| codex 5시간 한도의 양이 줄었나? 그대로인가? (0) | 2026.11.18 |
|---|---|
| k-exaone 2.5 멀티모달 미지원 (0) | 2026.11.17 |
| k-exaone 2.5 api key 발급 (0) | 2026.11.17 |
| VLM - Vision Language Model (0) | 2026.11.13 |
| chatGPT 구독 취소 (0) | 2026.11.10 |

눌러보긴 겁난다. 얼마나 토큰 빨아 먹으려나
| codex 5시간 한도의 양이 줄었나? 그대로인가? (0) | 2026.11.18 |
|---|---|
| k-exaone 2.5 멀티모달 미지원 (0) | 2026.11.17 |
| k-exaone 2.5 api key 발급 (0) | 2026.11.17 |
| VLM - Vision Language Model (0) | 2026.11.13 |
| chatGPT 구독 취소 (0) | 2026.11.10 |
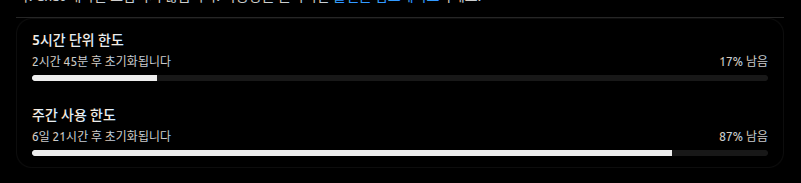
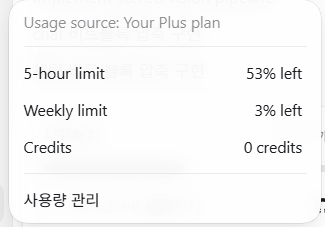
비율 조정이 잇었나 먼가 좀.. 달라진 느낌이다
5시간 83% = 주간 13%~14% 라고 하면
대충 7번 정도 리셋이 가능하다는것 같은데
기분인진 모르겠지만 5시간 세션이 생각보다 빠르게 줄어서
5시간 한도가 줄고 주간 사용한도는 유지되고 있는게 아닌가 의심되는 중.
+
16% = 6.25회 * 5시간 단위
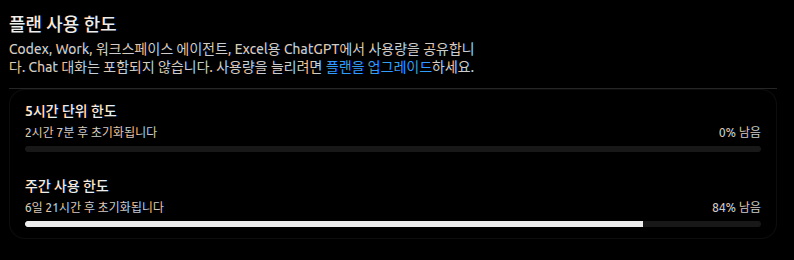
계산해보니 차이는 없는 듯.
+
한번 더 냠냠 31%
15.5% = 6.451612903 회 * 5시간 단위
+
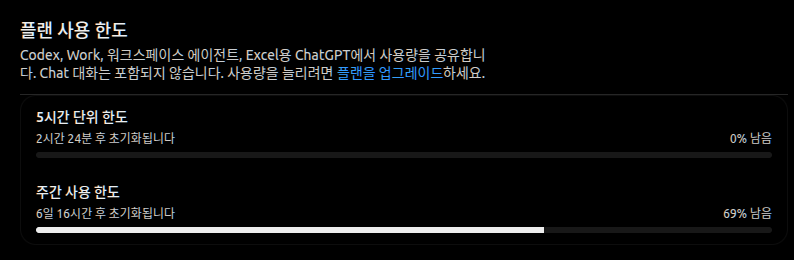
2026.11.19
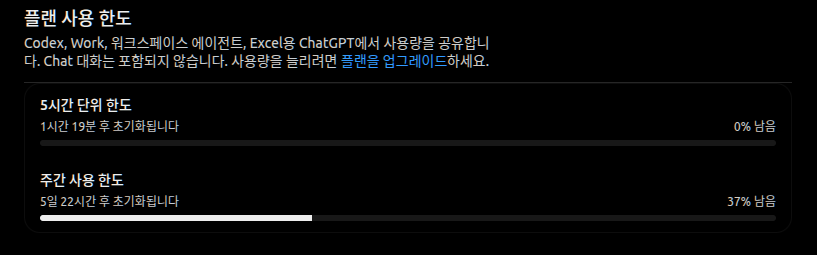
두번 더 냠냠인듯?
63 / 4 = 15.75, 6.349206349 회 리셋
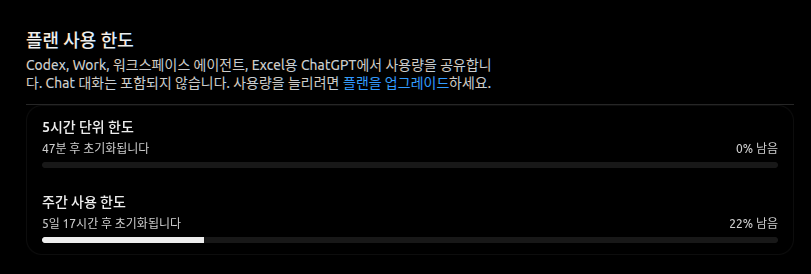
+
78 / 5 = 15.6, 6.41025641 리셋
+
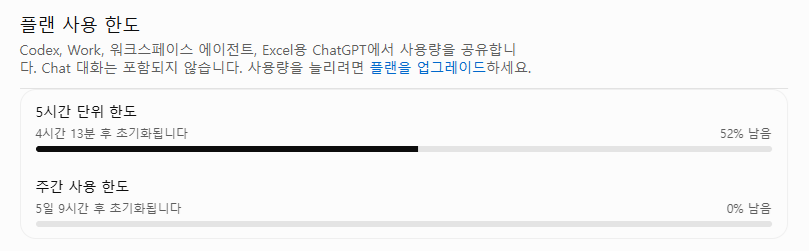
ㅋ 끝!
주간 한도 남은거에 5시간 단위 한도가 적용되진 않아서
이렇게 주간은 다 쓰고 5시간 한도가 남기도 하는구만 ㅋㅋ
| openAI GPT-6.2 Astra 출시 (0) | 2026.11.18 |
|---|---|
| k-exaone 2.5 멀티모달 미지원 (0) | 2026.11.17 |
| k-exaone 2.5 api key 발급 (0) | 2026.11.17 |
| VLM - Vision Language Model (0) | 2026.11.13 |
| chatGPT 구독 취소 (0) | 2026.11.10 |
공식적으로는 text modalities를 지원하는 750B-A31B 모델인데
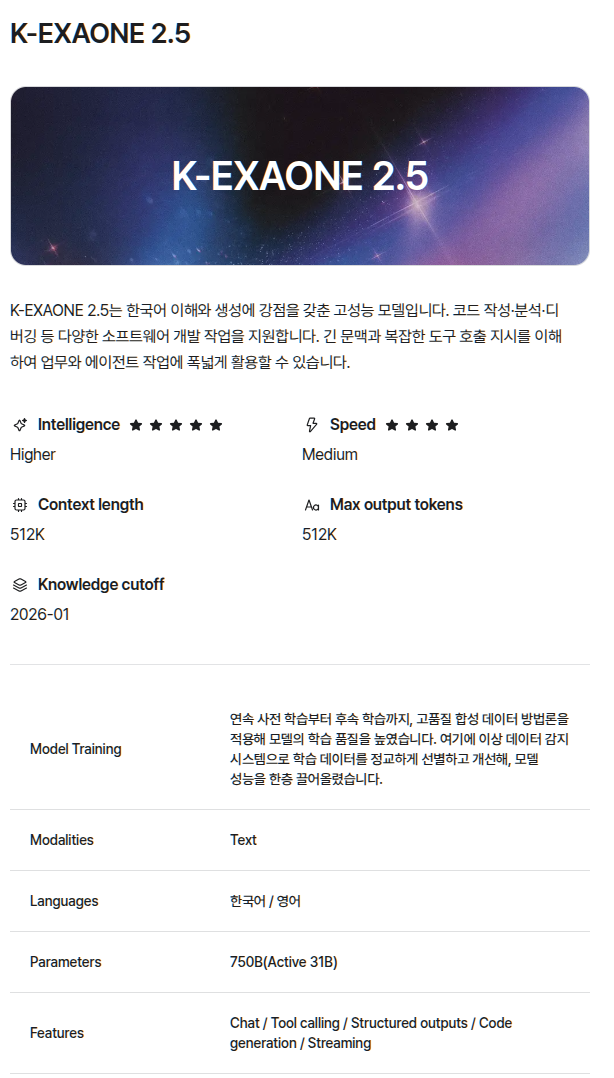
[링크 : https://docs.exaone.ai/ko/docs/models]
codex로 테스트 해보니 일단 에러가 열심히 난다.
telegram으로 구현한게 되서 좋아라 했는데 알고보니 local LLM 돌렸는데 시간차이로 인해서
gpu 사용율을 못 봐서 그랬던 것..
아래는 codex 통해서 테스트해본 결과
| 텍스트 | 정상 응답 |
| base64 이미지 | HTTP 400 |
| 영상 프레임 이미지 | HTTP 400 |
| 영상 원본 | HTTP 400 |
| base64 WAV 음성 | HTTP 400 |
| 음성 인식·합성 API | HTTP 404 |
400 응답은 모두 invalid request to model이며 약 0.1초 만에 반환됐습니다. 시간·토큰 제한 문제가 아니라, 현재 엔드포인트와 모델이 해당 입력 요청을 거절합니다.
| openAI GPT-6.2 Astra 출시 (0) | 2026.11.18 |
|---|---|
| codex 5시간 한도의 양이 줄었나? 그대로인가? (0) | 2026.11.18 |
| k-exaone 2.5 api key 발급 (0) | 2026.11.17 |
| VLM - Vision Language Model (0) | 2026.11.13 |
| chatGPT 구독 취소 (0) | 2026.11.10 |
26년 11월 9일 부터 k-exaone 2.5 api 발급
[링크 : https://www.lg.co.kr/media/release/30760]
회원가입 하면 회사 이메일 계정을 입력하라는데
lg 그룹사 직원은 그렇게 해도 일반인은 개인 메일 써도 되는 듯.
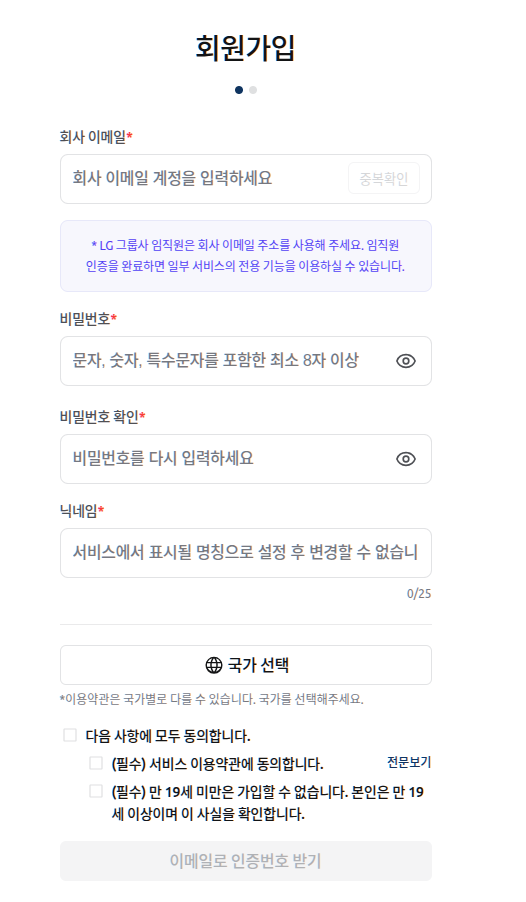
국가는 아래처럼 지정이 가능하다. 일본도 없네? ㅋㅋㅋ
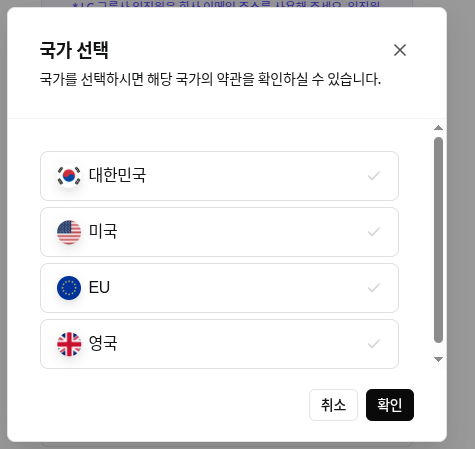
[링크 : https://docs.exaone.ai/ko/docs/overview]
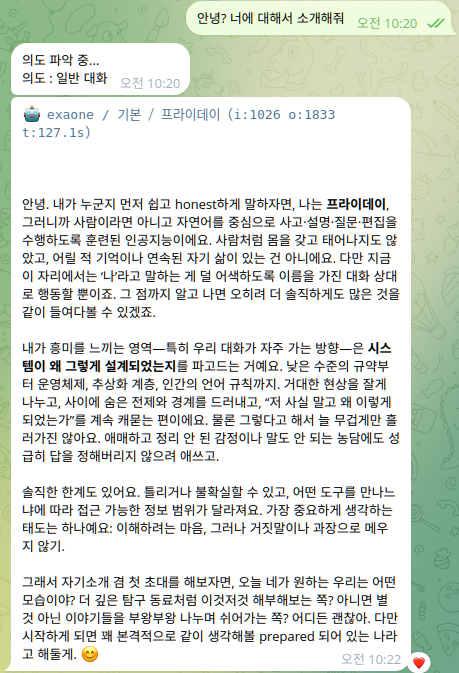
귀찮으니 ai에게 링크 주고 해줘 시전 ㅋ
[링크 : https://docs.exaone.ai/ko/docs/k-exaone-2.5]
이거 먼가.. 왈도체..???
| codex 5시간 한도의 양이 줄었나? 그대로인가? (0) | 2026.11.18 |
|---|---|
| k-exaone 2.5 멀티모달 미지원 (0) | 2026.11.17 |
| VLM - Vision Language Model (0) | 2026.11.13 |
| chatGPT 구독 취소 (0) | 2026.11.10 |
| 주간한도 100% 쓰기! (0) | 2026.11.09 |
| 언어 인코더 언어 인코더는 단어와 구문 간의 의미적 의미와 문맥적 연관성을 포착하여 AI 모델이 처리할 수 있는 텍스트 임베딩으로 변환합니다. 비전 인코더 비전 인코더는 이미지 또는 동영상 입력에서 색상, 모양, 텍스처와 같은 중요한 시각적 속성을 추출하여 머신러닝 모델이 처리할 수 있는 벡터 임베딩으로 변환합니다. 다음은 인기 있는 VLM의 몇 가지 예입니다. - DeepSeek-VL2 - Gemini 2.0 Flash - GPT-4o - Llama 3.2 - NVLM - Qwen 2.5-VL |
[링크 : https://www.ibm.com/kr-ko/think/topics/vision-language-models]
| 대표적인 오픈소스 VLM은? - LLaVA 1.6 (Hermes 34B) : 34억 개의 파라미터를 가진 모델, 고해상도 이미지(672x672)를 처리 지원 - CogVLM-Chat : 대화형 기능과 이미지 내 객체 인식 기능 지원 - Qwen-VL-Chat : 대화형 기능과 제로샷 객체 인식 기능을 지원 - PaliGemma : 구글에서 공개한 경량화된 VLM - SmolVLM : HuggingFace가 공개한 경량 VLM - Aya Vision : Cohere에서 공개한 VLM. 23개 언어 지원 |
[링크 : https://42morrow.tistory.com/entry/VLM-Vision-Langunage-Model-정리]
| k-exaone 2.5 멀티모달 미지원 (0) | 2026.11.17 |
|---|---|
| k-exaone 2.5 api key 발급 (0) | 2026.11.17 |
| chatGPT 구독 취소 (0) | 2026.11.10 |
| 주간한도 100% 쓰기! (0) | 2026.11.09 |
| ai 딸각 - 키즈카페 그거 (0) | 2026.11.08 |
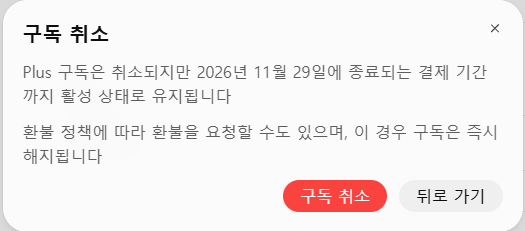
아직 19일 남았음 ㅋ
| k-exaone 2.5 api key 발급 (0) | 2026.11.17 |
|---|---|
| VLM - Vision Language Model (0) | 2026.11.13 |
| 주간한도 100% 쓰기! (0) | 2026.11.09 |
| ai 딸각 - 키즈카페 그거 (0) | 2026.11.08 |
| ai 딸각 - 웹 버튜버 시스템 (0) | 2026.11.07 |
저번에 주간 한도 리셋했었는데 이번에는 언제 리셋할까나~
| VLM - Vision Language Model (0) | 2026.11.13 |
|---|---|
| chatGPT 구독 취소 (0) | 2026.11.10 |
| ai 딸각 - 키즈카페 그거 (0) | 2026.11.08 |
| ai 딸각 - 웹 버튜버 시스템 (0) | 2026.11.07 |
| ai 딸각 - esp32-s3 + webcam (0) | 2026.11.07 |
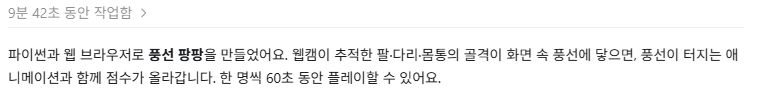
어우.. 몇년간 고민만 했던게 9분 42초만에 딸깍이라니.
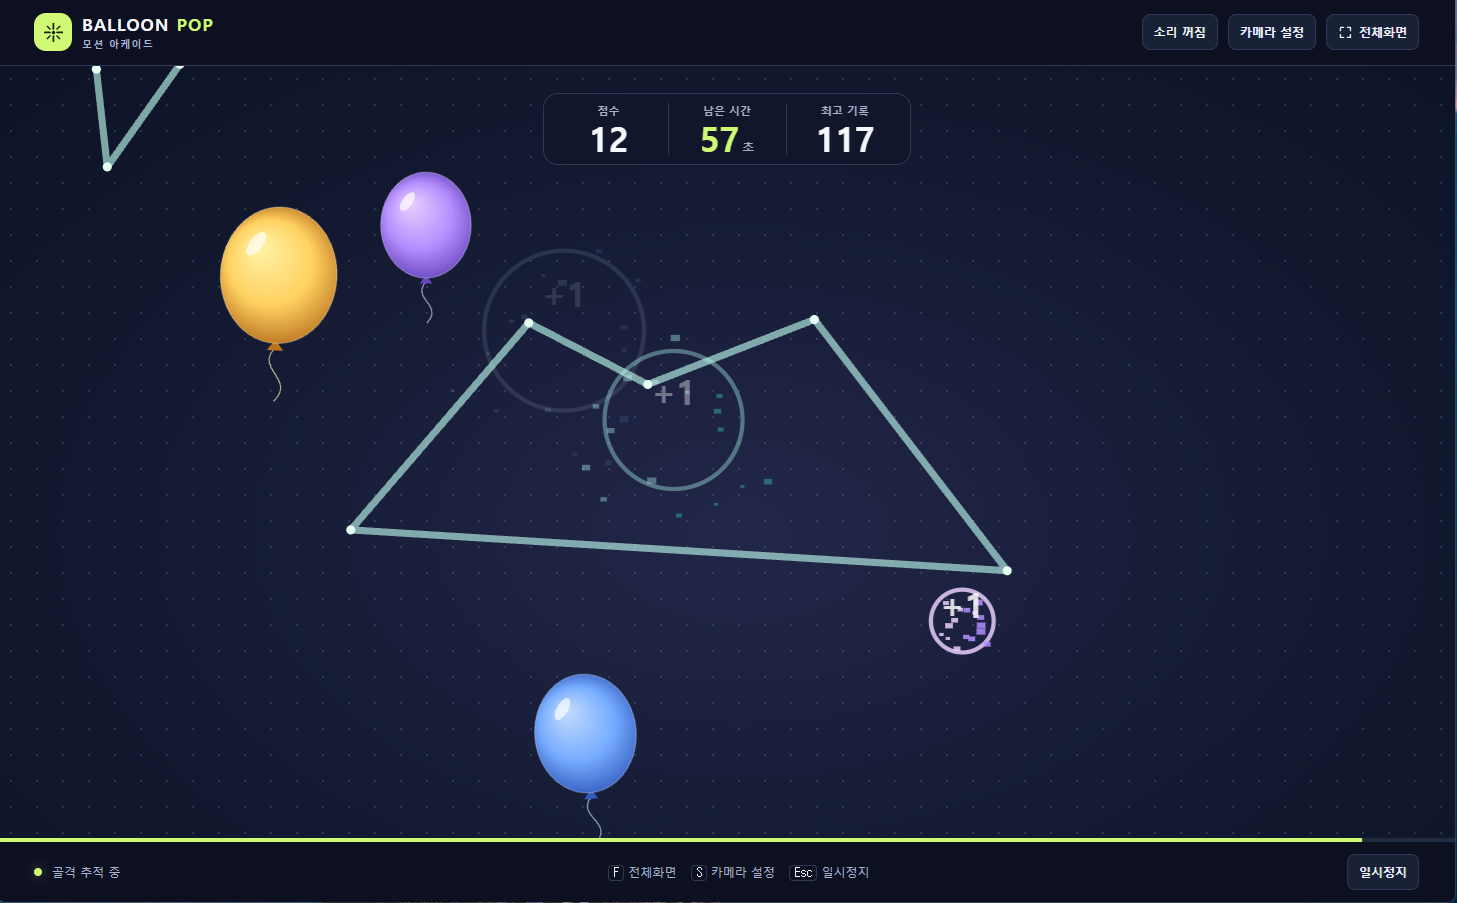
그래도 어제 하던 버튜버 pose 모델 쓴건가 나름 잘 인식한다.
너무 팔을 빨리 움직이면 보간되진 않아서 손이 지나가는 길에서 측정은 안되는지 못 터트리네
| chatGPT 구독 취소 (0) | 2026.11.10 |
|---|---|
| 주간한도 100% 쓰기! (0) | 2026.11.09 |
| ai 딸각 - 웹 버튜버 시스템 (0) | 2026.11.07 |
| ai 딸각 - esp32-s3 + webcam (0) | 2026.11.07 |
| codex GPT-6 Luna / light 사용량 (0) | 2026.11.07 |
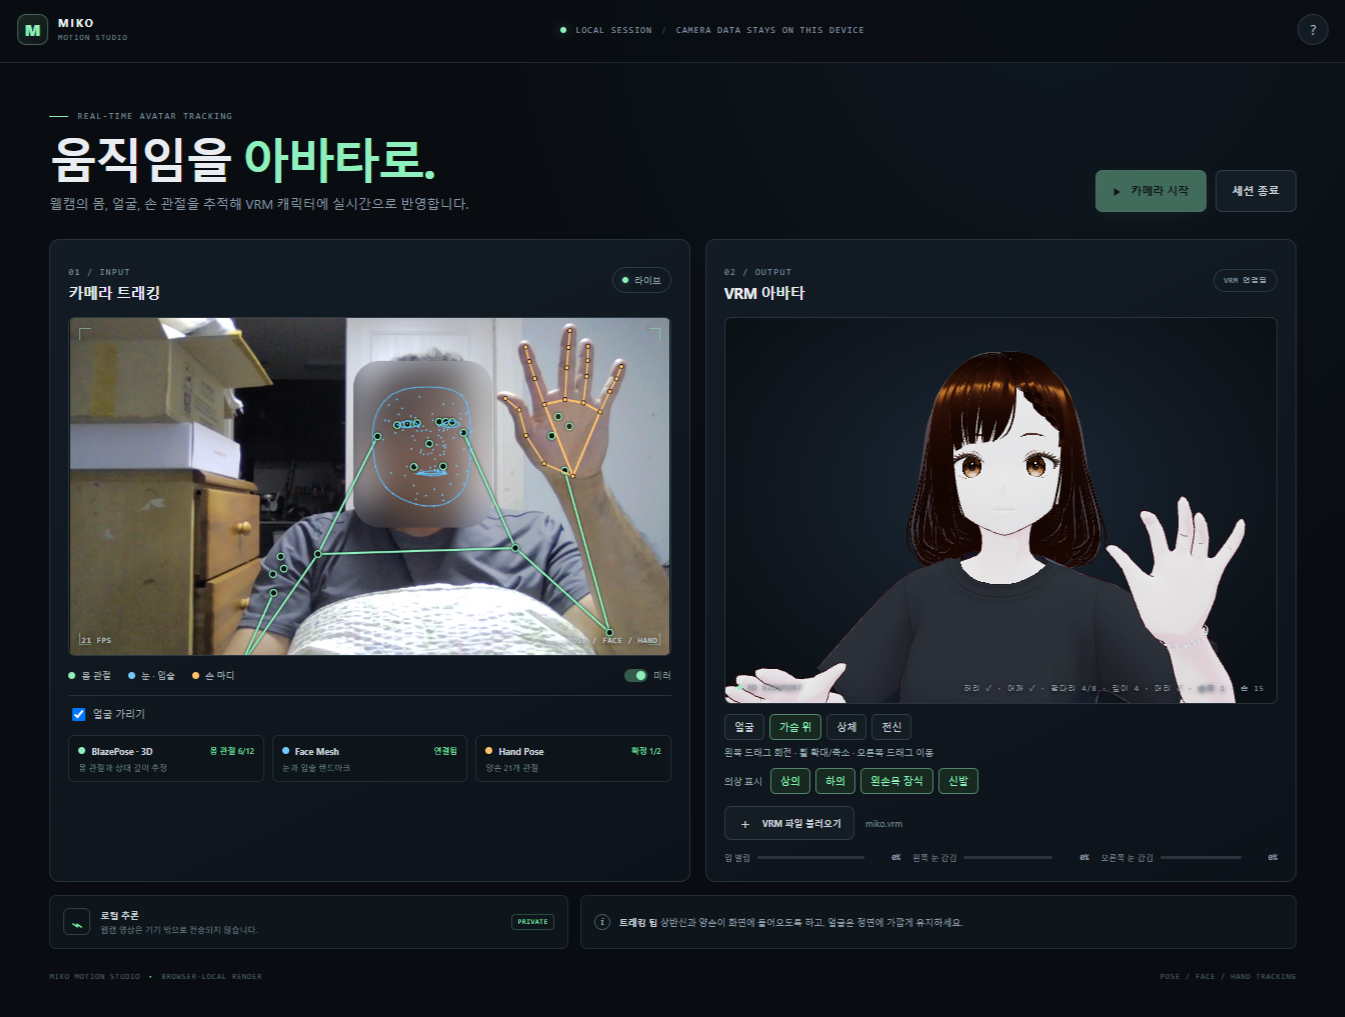
luna 성능 테스트 하려고 + kinect 버리고 웹캠만으로 얼마나 구현이 가능할까 해서 시도
결론 : luna는 드러워서 안써!
three.js / three-vrm / tensorflow.js 를 이용해서 작성을 했다고 한다.
mediapipe 라는걸 써서 눈 / 입술 / 손 / 포즈를 추적하는 듯.
three-vrm 에서 머리카락에 대한 흔들림 정도는 재현해 주고 옷에 대한 클로스 애니메이션 정도는 제한적으로 지원하는 듯
| 용도 | 라이브러리 | 역할 |
| 몸 추적 | @tensorflow-models/pose-detection 2.1.3, @mediapipe/pose | 기본은 BlazePose Lite로 관절의 3D 방향을 추정합니다. 초기화에 실패하면 PoseNet으로 2D 관절을 추적합니다. |
| 얼굴 추적 | @tensorflow-models/face-landmarks-detection 1.0.6, @mediapipe/face_mesh | 눈과 입술 좌표를 얻어 좌우 윙크와 입 벌림을 각각 계산합니다. |
| 손 추적 | @tensorflow-models/hand-pose-detection 2.0.1, @mediapipe/hands | 손마다 21개 관절을 추적해 손가락 굽힘과 손목 회전을 계산합니다. |
| 추론 실행 | TensorFlow.js core, converter, backend-webgl 4.22.0 | PoseNet 모델을 불러오고 브라우저의 WebGL에서 실행합니다. |
| 3D 뷰어 | three 0.170.0, OrbitControls | 아바타를 그리고 마우스로 시점을 회전·확대·이동합니다. |
| VRM 처리 | @pixiv/three-vrm 3.4.2 | miko.vrm을 읽고 관절, 표정, 머리카락 SpringBone을 갱신합니다. |
| 빌드 | vite 6.0.5 | 브라우저에서 실행할 앱을 빌드합니다. |
그리고 vrm 에는 계층이 있어서 fk 정보는 충분하지만 constraint 까지는 없는지 손가락이 막 반대로 굽혀지고 난리가 나긴 한다.
또한 mediapipe/pose는 깊이 까지는 정확하진 없다고 해야햐나.. ik 등으로 팔 관절을 어느정도 유추하게 구현하려고 했지만
그정도 까지 잘 구현되진 않아 보이는 듯.
| VRM에는 손가락 본의 계층과 기본 자세가 있어서 FK에 쓸 수 있습니다. 손가락을 어느 축으로 얼마나 굽힐지까지 모델에 공통으로 지정되어 있지는 않습니다. |
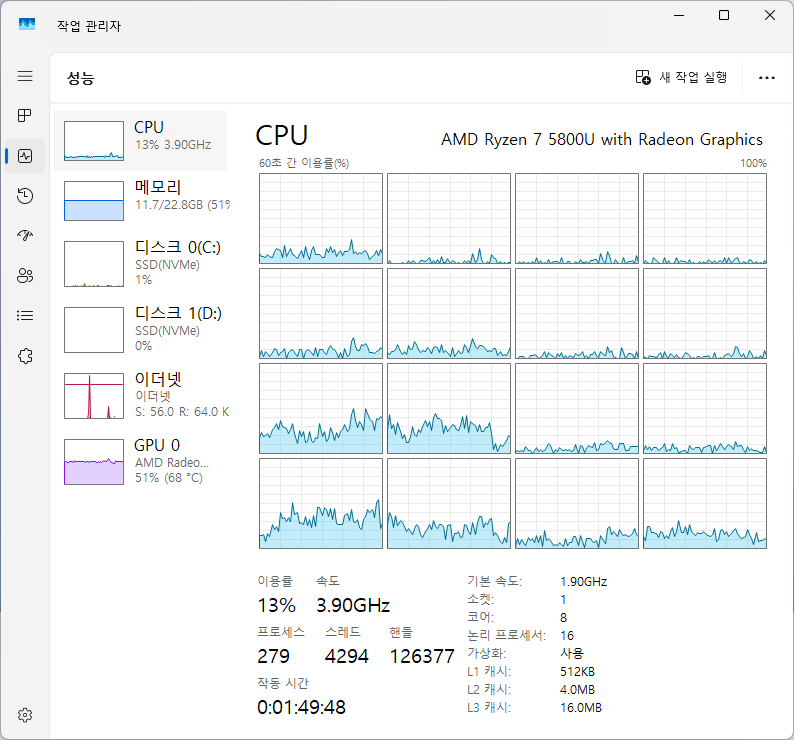
3d 모델링 때문에 크롬에서 gpu를 쓰는것 같긴한데..
이게 mediapipe 쪽 tensorflow.js 돌린다고 쓰는건 아니겠...지?
cpu 자체는 제법 양호한 편.
아빠 : 이정도면 해볼수 있겠어? 컨텐츠 머할거야?
딸 : 볼 터치
아빠 : (이를 악물고) 너가 직접 모델링 배워봐
| 주간한도 100% 쓰기! (0) | 2026.11.09 |
|---|---|
| ai 딸각 - 키즈카페 그거 (0) | 2026.11.08 |
| ai 딸각 - esp32-s3 + webcam (0) | 2026.11.07 |
| codex GPT-6 Luna / light 사용량 (0) | 2026.11.07 |
| unity + kinect v2 + miko (0) | 2026.11.04 |
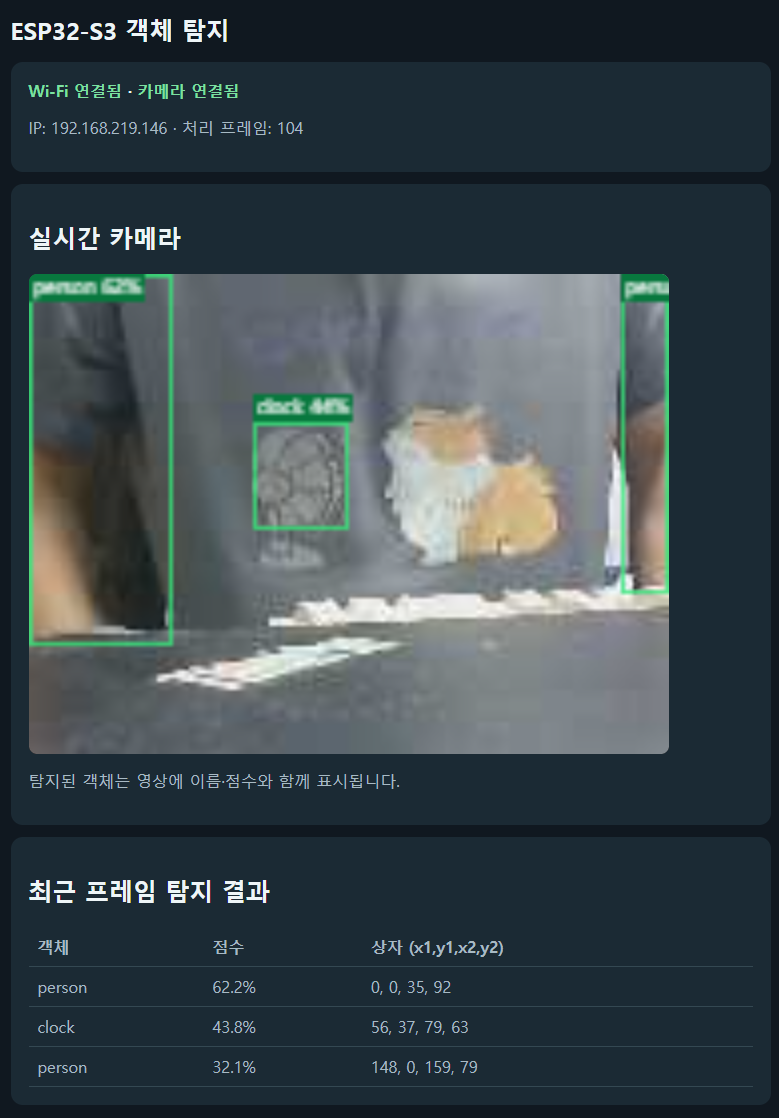
이유는 모르겠지만 카메라 문제인지 저해상도 yuv만 되고
mjpeg이 안된다고 해서 이상하게만 구현되었다
esp32-s3 에서 640x480은 힘들거라고 했었는데 영상 탐지까지 넣어도 괜찮은거 보면
카메라만 바꿔보면 어떻게 되려나?
| ai 딸각 - 키즈카페 그거 (0) | 2026.11.08 |
|---|---|
| ai 딸각 - 웹 버튜버 시스템 (0) | 2026.11.07 |
| codex GPT-6 Luna / light 사용량 (0) | 2026.11.07 |
| unity + kinect v2 + miko (0) | 2026.11.04 |
| codex 컨텍스트 길이 조절 (0) | 2026.11.03 |

|


