근본 이유 - WS2812B: LED 하나당 드라이버 IC가 하나씩 내장(개별 어드레싱) → LED 개수만큼 IC 비용이 그대로 곱해짐 - HUB75: LED 여러 개(보통 16개)를 드라이버 IC 하나(MBI5124 등)가 묶어서 구동 → IC 개수가 LED 개수의 1/16 수준이라 원가가 확 낮음 - 게다가 HUB75는 옥외광고/전광판 산업에서 이미 수백만 장 양산되는 표준품이라 규모의 경제까지 붙음
대략적인 단가 비교 (픽셀피치 1cm 기준으로 맞춰서) - WS2812B 8×8 모듈(8cm×8cm=64cm²): 약 2,500원 → 약 39원/cm² - HUB75 P10 판넬(32×16px, 32cm×16cm=512cm²): 알리 기준 대략 10,000~15,000원 → 약 20~29원/cm²
→ 같은 면적, 비슷한 해상도 밀도 기준으로 HUB75가 30~50% 정도 저렴한 편입니다.
64×64(64cm×64cm) 전체로 환산하면 - WS2812B: 아까 계산한 16만원 - HUB75(같은 픽셀피치 P10 기준, 32×32px 판넬 4장 정도 조합): 대략 4~6만원대로 절반 이하까지 내려갈 수 있음
덤으로 따라오는 이점 - HUB75 판넬은 애초에 체이닝용 커넥터 + 판넬 내 전원 분배가 설계되어 있어서, 아까 얘기한 "전원 주입 지점 직접 설계" 부담이 훨씬 줄어듭니다 (완전히 없어지진 않지만 DIY WS2812보다 훨씬 정형화됨)
대신 치러야 할 비용은 복잡도 - 드라이버가 HUB75 전용 스캔+BCM 방식이라 소프트웨어를 새로 짜야 함 (지금 있는 WS2812 코드 재사용 불가, 전에 말씀드린 대로) - MCU도 RPi나 ESP32-S3처럼 DMA로 지속 스캔 감당할 수 있는 걸 써야 함
정리하면 돈은 HUB75가 이기고, 개발 난이도는 WS2812가 더 쉬움 — 트레이드오프입니다. 64개 패널 사기 전에 HUB75 견적도 한 번 비교해보시는 게 좋을 것 같아요.
/* Cortex-M3 DWT 사이클 카운터 활성화 (마이크로초 이하 정밀 타이밍용) */ static void DWT_Init(void) { CoreDebug->DEMCR |= CoreDebug_DEMCR_TRCENA_Msk; DWT->CYCCNT = 0; DWT->CTRL |= DWT_CTRL_CYCCNTENA_Msk; }
/* 비트 1개 전송: 기준 시각(start) 대비 상대시간으로 High->Low 구간을 제어해 * 분기/함수호출 오버헤드로 인한 지터를 최소화한다. * always_inline: -O0 빌드에서도 GCC가 반드시 인라인하도록 강제 (그냥 inline은 * -O0에서 무시되어 매 비트마다 진짜 함수호출(push/pop)이 발생, 비트 사이 LOW * 구간이 수십배 길어져 스트립이 매 비트를 리셋으로 오인하는 문제가 있었음). */ __attribute__((always_inline)) static inline void ws2812_send_bit(uint8_t bit) { uint32_t start = DWT->CYCCNT; uint32_t high_cycles = bit ? WS_T1H_CYCLES : WS_T0H_CYCLES;
WS2812_PORT->BSRR = WS2812_PIN; /* Data line High */ while ((DWT->CYCCNT - start) < high_cycles) { } WS2812_PORT->BSRR = (uint32_t)WS2812_PIN << 16U; /* Data line Low */ while ((DWT->CYCCNT - start) < WS_BIT_CYCLES) { } }
__attribute__((always_inline)) static inline void ws2812_send_byte(uint8_t byte) { for (int8_t i = 7; i >= 0; i--) { ws2812_send_bit((byte >> i) & 0x01U); } }
/* led_grb[] 버퍼 내용을 스트립으로 전송. 전송 중 인터럽트(특히 USB)로 인한 * 타이밍 흐트러짐을 막기 위해 전송 구간만 짧게(약 1.92ms/64LED) IRQ를 끈다. * * 전송 전에 예상 총 전류(mA)를 계산해서 WS_MAX_TOTAL_MA를 넘으면 전체 밝기를 * 비율대로 깎아서 보낸다. led_grb[]는 원본 그대로 두고(다음 프레임 색상 계산에 * 영향 없음), 실제 출력만 스케일한다. */ static void ws2812_show(void) { uint32_t est_ma = (uint32_t)NUM_LEDS * WS_MA_IDLE_PER_LED; for (uint32_t i = 0; i < NUM_LEDS; i++) { uint32_t sum = (uint32_t)led_grb[i][0] + led_grb[i][1] + led_grb[i][2]; est_ma += (sum * WS_MA_PER_CH_FULL) / 255U; }
/* scale: 256 = 그대로, 그보다 작으면 그 비율만큼 줄임 (고정소수점 8bit) */ uint32_t scale = 256U; if (est_ma > WS_MAX_TOTAL_MA) { scale = (WS_MAX_TOTAL_MA * 256U) / est_ma; }
__disable_irq(); for (uint32_t i = 0; i < NUM_LEDS; i++) { ws2812_send_byte((uint8_t)((led_grb[i][0] * scale) >> 8)); /* G */ ws2812_send_byte((uint8_t)((led_grb[i][1] * scale) >> 8)); /* R */ ws2812_send_byte((uint8_t)((led_grb[i][2] * scale) >> 8)); /* B */ } __enable_irq(); /* Reset/Latch(>=50us Low)은 다음 프레임까지의 HAL_Delay 구간이 충분히 커버함 */ }
위키피디아 영문/한글 두개 넣어서 돌리면 알아서 번역가능한거 아니냐 하니 그건또 아니라고 한다. ㅠㅠ
정확하게 매칭된 한 문장이 다른 분장으로 번역된 쌍이 필요한 것 이라고.
그럼 결국 기계번역도 수 많은 번역을 해온 자원봉사자들의 위에 우리가 혜택을 누리는건가..
한국어 위키의 "서울" 문서와 영어 위키의 "Seoul" 문서는 서로 번역이 아닙니다. 각각 별도의 저자들이 독립적으로 쓴 글이라, 분량도 다르고, 다루는 내용도 다르고, 문장 순서도 다릅니다. 두 코퍼스를 그냥 섞어서 "다음 토큰 맞추기"로 학습시키면, 모델은 "이 한국어 문단과 저 영어 문단이 같은 의미다"라는 신호를 전혀 받지 못합니다 — 그냥 같은 파라미터 공간 안에 두 개의 독립된 언어 능력이 나란히 쌓일 뿐이지, 둘을 잇는 다리가 저절로 생기지 않습니다. 지난번 "베이스 모델이 처음 보는 지식은 SFT로 못 만든다"는 얘기와 같은 원리가 여기도 적용됩니다 — 정렬(alignment) 신호가 없는 데이터는 아무리 섞어도 번역 능력을 만들지 않습니다.
실제로 이걸 해낸 방법이 있습니다 — WikiMatrix
Meta(당시 Facebook AI)가 정확히 "위키백과에서 자동으로 문장 쌍을 뽑아내는" 문제를 풀었습니다:
- LASER라는 다국어 문장 임베딩 모델로 93개 언어의 문장을 같은 벡터 공간에 투영 - 한국어 문장과 영어 문장의 벡터가 얼마나 가까운지(의미적으로 비슷한지) 계산해서, 진짜로 비슷한 뜻인 문장 쌍만 골라냄 - 이렇게 85개 언어에서 1억 3,500만 개 병렬 문장을 자동으로 채굴했고, 결과물이 공개돼 있습니다
즉 "위키 두 개를 그냥 넣는 것"과 "WikiMatrix식으로 의미 유사도를 계산해서 진짜 대응 문장만 골라내는 것" 사이엔 **완전히 다른 파이프라인 하나(문장 임베딩 모델 + 유사도 필터링)**가 끼어 있습니다. 다행히 이건 우리가 처음부터 만들 필요 없이, WikiMatrix가 이미 뽑아놓은 한영 병렬 문장 쌍을 가져다 쓰는 게 현실적입니다.
정리하면
❌ 한국어 위키 + 영어 위키를 그냥 같이 넣기 → 두 언어를 "따로따로" 아는 모델은 될 수 있어도, 번역은 안 됨
✅ WikiMatrix 같은 이미 정렬된 병렬 코퍼스를 사전학습/SFT에 넣기 → "이 한국어 문장 = 이 영어 문장"이라는 신호가 명시적으로 존재
출력층은 별도 파라미터 없이 임베딩 행렬을 그대로 재사용합니다(tied embedding) — 입력 임베딩과 출력 확률 계산이 같은 32,448×512 행렬을 공유해서 파라미터를 아낍니다.
블록 1개(3,211,264개) 안에서는 어텐션이 1,048,576개, SwiGLU가 2,162,688개로 FFN이 어텐션의 약 2배 차지합니다. 이건 LLaMA류의 전형적인 비율입니다.
입력 토큰 id → 임베딩(emb) : id → 512차원 벡터 → [블록 × 8] x = x + Attention(RMSNorm(x)) : 잔차 연결 1 x = x + SwiGLU(RMSNorm(x)) : 잔차 연결 2 → 최종 RMSNorm(norm) → emb.weight.T 와 곱함 : 512차원 → 32,448개 토큰 확률(logits)
- RMSNorm: LayerNorm의 경량 버전. 평균을 빼지 않고 제곱평균으로만 스케일을 맞춥니다(x * rsqrt(mean(x²))). 학습 가능한 스케일 벡터 w 하나만 가집니다(bias 없음). LLaMA/Gemma 계열이 공통으로 쓰는 방식이고, 일반 LayerNorm보다 계산이 싸고 안정적입니다. - rope(x, cos, sin): 회전 위치 인코딩(RoPE). Q, K 벡터를 절반씩 잘라(x1, x2) 2D 회전을 적용해서 "이 토큰이 몇 번째 위치인가"를 벡터 자체에 새겨 넣습니다. 별도의 위치 임베딩 파라미터가 없고, 상대적 거리 정보가 자연스럽게 학습됩니다. - Attention: - qkv 선형층 하나로 Q/K/V를 한 번에 계산(512 → 1536) - 8개 헤드로 나눠 각각 RoPE 적용 - F.scaled_dot_product_attention(..., is_causal=True) — PyTorch 내장 함수로, 이 안에서 Flash Attention 커널이 자동 선택됩니다(가능한 하드웨어에서). causal=True라 미래 토큰을 보지 못하게 마스킹됩니다. - GQA/MQA 없이 순수 MHA(8쿼리헤드=8키헤드) — 이전에 설명드렸듯 이 모델 크기·문맥길이(512)에서는 KV 캐시 절감 이득보다 품질 손실이 더 클 수 있어 안 씁니다. - 마지막에 o 선형층으로 다시 섞음. - SwiGLU: 게이트 달린 FFN. w13이 두 벡터(a, b)를 동시에 뽑고, silu(a) * b로 게이팅한 뒤 w2로 다시 512차원으로 축소. 일반 ReLU-FFN보다 표현력이 좋다고 알려져 LLaMA/PaLM 계열이 표준으로 씁니다. - Block: 위 둘을 Pre-Norm 방식(정규화 먼저, 그다음 서브레이어)으로 감싸고 잔차 연결. GPT-2식 Post-Norm보다 학습이 안정적입니다. - 초기화: 일반 가중치는 std=0.02 정규분포. 단, 각 블록의 "잔차에 더해지는 마지막 선형층"(attn.o, mlp.w2)은 0.02/sqrt(2*8)로 더 작게 초기화합니다 — 층이 깊어질수록 잔차 누적으로 분산이 커지는 걸 막는 GPT-2/nanoGPT식 트릭입니다. - forward: 학습 시 targets를 주면 다음 토큰 예측 교차엔트로피 손실까지 한 번에 계산. logits.view(-1, V) 형태로 펴서 전체 배치·시퀀스 위치를 한꺼번에 손실 계산합니다. - generate: 자기회귀 생성 루프. - 매 스텝 마지막 block_size(512) 토큰만 잘라서 forward (문맥 길이 제한) - temperature로 확률 분포를 누그러뜨리고, top_k로 후보를 40개로 제한한 뒤 multinomial로 샘플링 (확률적 생성 — 어제 보여드린 samples.txt가 이 방식) - eos_id를 만나면 조기 종료 (SFT용으로 <|end|> id를 넘길 수 있게 만들어둔 파라미터) - 제가 별도로 검증할 때 쓴 "탐욕적(top_k=1 상당)" 생성은 이 함수를 안 쓰고 argmax로 직접 만든 스크립트였습니다 — 결정적 결과 확인용.
설정값 (Config)
┌──────────────────────────────────┬────────────────────────────────────────────────────────────────────────────────────────────────┐ │ 값 │ 의미 │ ├──────────────────────────────────┼────────────────────────────────────────────────────────────────────────────────────────────────┤ │ vocab_size=32448 │ 실제 토큰 32,408개를 GPU 효율을 위해 64의 배수로 패딩 (GGUF 내보낼 때는 실제 개수로 다시 자름) │ ├──────────────────────────────────┼────────────────────────────────────────────────────────────────────────────────────────────────┤ │ block_size=512 │ 한 번에 볼 수 있는 최대 토큰 수 (문맥 길이) — llama-cli 대화 모드에서 넘치면 에러 나던 원인 │ ├──────────────────────────────────┼────────────────────────────────────────────────────────────────────────────────────────────────┤ │ n_layer=8, n_head=8, d_model=512 │ 8층, 헤드당 64차원(512/8) │ ├──────────────────────────────────┼────────────────────────────────────────────────────────────────────────────────────────────────┤ │ ffn_hidden=1408 │ SwiGLU 내부 확장 차원 │ ├──────────────────────────────────┼────────────────────────────────────────────────────────────────────────────────────────────────┤ │ rope_base=10000.0 │ RoPE 회전 주파수 기준값 (LLaMA 기본값과 동일) │ └──────────────────────────────────┴────────────────────────────────────────────────────────────────────────────────────────────────┘
총평: 이 모델은 아키텍처 자체는 실제 LLaMA/Mistral과 완전히 동일한 축소판입니다(RMSNorm+RoPE+SwiGLU+tied embedding+causal MHA). 차이는 오직 규모(8층/512차원 vs 수십층/수천차원)와 GQA 유무뿐이라, 여기서 배운 구조 지식은 실제 대형 오픈소스 모델을 읽을 때 그대로 적용됩니다.
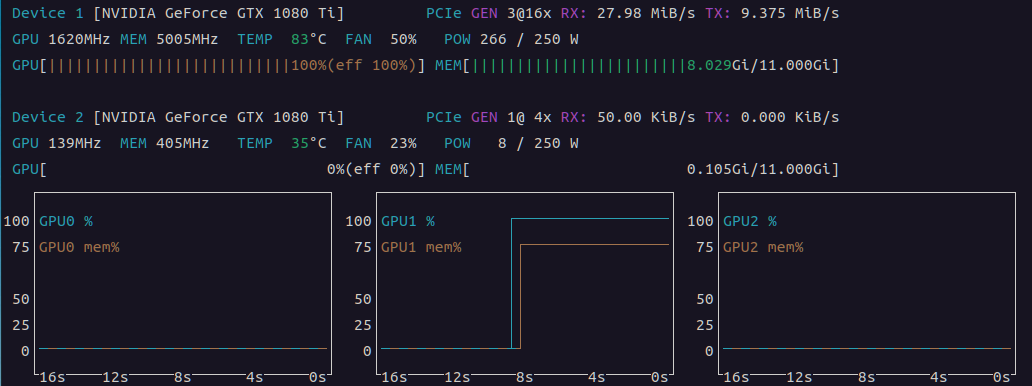
┌────────────────────┬───────────────────────────────────────────┬──────────────────────────────────────────────────────────────────────┐ │ 항목 │ 이 프로젝트(seoan1024) │ llm-ko(여기) │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 정규화/위치/활성화 │ RMSNorm + RoPE + SwiGLU │ 동일 │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 임베딩 공유 │ O │ O │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 파라미터 수 │ 약 1.09B │ 약 42.3M (25배 작음) │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 레이어/은닉/헤드 │ 20층 / 1920차원 / 10헤드 │ 8층 / 512차원 / 8헤드 │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 토크나이저 │ 남의 것 재사용 (beomi/Llama-3-Open-Ko-8B) │ 직접 학습(SentencePiece Unigram, 32,408개) │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 정밀도 │ BF16 │ fp32 (우리 GPU는 Pascal이라 fp16/bf16 이득 없음, 이전에 실측 확인함) │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 학습 단계 │ pretrain → SFT 2단계 │ 동일 구조 (base → sft, pipeline.sh) │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 라이선스 │ GPL-3.0 │ 목표: Apache-2.0/MIT │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 요구 하드웨어 │ RTX 3060 이상, RAM 64GB, 1TB NVMe │ GTX 1080 Ti ×2 (훨씬 낮은 사양 지향) │ └────────────────────┴───────────────────────────────────────────┴──────────────────────────────────────────────────────────────────────┘
왜 비슷해 보이는가
RMSNorm+RoPE+SwiGLU+임베딩공유 조합은 LLaMA가 2023년에 공개한 이후 사실상 업계 표준이 됐습니다(Mistral, Gemma, Qwen 등도 동일 계열). 이건 특정 프로젝트의 독창적 아이디어가 아니라 공개된 논문·아키텍처를 다들 그대로 쓰는 것이라, "닮았다"기보다는 같은 표준 설계를 각자 구현한 것에 가깝습니다. 2단계(pretrain→SFT) 구조도 요즘 오픈소스 LLM 학습의 사실상 정석 흐름이고요.
실제 차이가 나는 지점은: - 규모: 저쪽은 1B급(RTX 4090 권장)까지 키웠고, 우리는 1080 Ti 2장으로 42M급을 목표로 함 - 토크나이저: 저쪽은 이미 있는 8B짜리 모델의 토크나이저를 가져다 씀. 우리는 처음부터 직접 학습 — 이게 우리 프로젝트에서 꽤 공들인 부분이라 차별점입니다 - 라이선스: 여기가 중요한데, 저쪽은 GPL-3.0입니다. 우리는 Apache/MIT를 목표로 하고 있으니 저 저장소의 코드를 참고해서 베끼면 안 됩니다(GPL은 파생물도 GPL로 강제). 지금까지 우리 코드는 제가 직접 작성했고 저 저장소를 본 적도 없으니 문제없지만, 앞으로도 저기 코드를 보고 옮겨오는 건 피해야 합니다 — 순수 아키텍처 개념(RMSNorm 수식 등)을 참고하는 것 자체는 문제없지만(아이디어는 저작권 대상이 아님), 코드 구현체를 그대로 가져오면 라이선스가 섞입니다.
요약하면: "같은 요리법(LLaMA 스타일)으로 만든 다른 레스토랑" 정도입니다. 걱정하실 만한 건 라이선스뿐이고, 그것도 우리가 독립적으로 작성한 코드라 문제없습니다.
/mnt/Downloads/llama-b10488/llama-tokenize -m base42m-q4_0.gguf -p "마이크로소프트" 0.00.303.842 W load: control-looking token: 7 '<|end|>' was not control-type; this is probably a bug in the model. its type will be overridden 3169 -> ' 마이크로소프트'
$ /mnt/Downloads/llama-b10488/llama-tokenize -m base42m-q4_0.gguf -p 대한민국 0.00.301.255 W load: control-looking token: 7 '<|end|>' was not control-type; this is probably a bug in the model. its type will be overridden 579 -> ' 대한민국' 0.00.316.277 W llama_context: n_ctx_seq (512) > n_ctx_train (0) -- possible training context overflow
$ /mnt/Downloads/llama-b10488/llama-tokenize -m base42m-q4_0.gguf -p 강아지 0.00.302.451 W load: control-looking token: 7 '<|end|>' was not control-type; this is probably a bug in the model. its type will be overridden 26760 -> ' 강아지'
$ /mnt/Downloads/llama-b10488/llama-tokenize -m base42m-q4_0.gguf -p 송아지 0.00.305.743 W load: control-looking token: 7 '<|end|>' was not control-type; this is probably a bug in the model. its type will be overridden 1259 -> ' 송' 382 -> '아' 299 -> '지'
혹시나 해서 gemma4 e4b에서 돌려보는데 어라.. 생각외로 그렇게 토큰을 많이 먹진 않는다고 해야하나?
$ /mnt/Downloads/llama-b10488/llama-tokenize -m gemma-4-E4B-it-Q4_K_M.gguf -p 마이크로소프트 0.00.926.382 W load: control-looking token: 212 '</s>' was not control-type; this is probably a bug in the model. its type will be overridden 0.00.927.107 W load: control-looking token: 50 '<|tool_response>' was not control-type; this is probably a bug in the model. its type will be overridden 0.00.937.154 W load: control-looking token: 1 '<eos>' was not control-type; this is probably a bug in the model. its type will be overridden 0.00.969.157 W load: special_eog_ids contains '<|tool_response>', removing '</s>' token from EOG list 0.01.001.080 W llama_context: n_ctx_seq (512) > n_ctx_train (0) -- possible training context overflow 2 -> '<bos>' 238098 -> '마' 106427 -> '이크' 237323 -> '로' 238049 -> '소' 128329 -> '프트'
$ /mnt/Downloads/llama-b10488/llama-tokenize -m gemma-4-E4B-it-Q4_K_M.gguf -p 대한민국 0.00.894.966 W load: control-looking token: 212 '' was not control-type; this is probably a bug in the model. its type will be overridden 0.00.895.695 W load: control-looking token: 50 '<|tool_response>' was not control-type; this is probably a bug in the model. its type will be overridden 0.00.905.756 W load: control-looking token: 1 '' was not control-type; this is probably a bug in the model. its type will be overridden 0.00.938.322 W load: special_eog_ids contains '<|tool_response>', removing '' token from EOG list 0.00.970.177 W llama_context: n_ctx_seq (512) > n_ctx_train (0) -- possible training context overflow 2 -> '' 146220 -> '대한' 162139 -> '민국'
$ /mnt/Downloads/llama-b10488/llama-tokenize -m gemma-4-E4B-it-Q4_K_M.gguf -p 강아지 0.00.915.146 W load: control-looking token: 212 '</s>' was not control-type; this is probably a bug in the model. its type will be overridden 0.00.915.894 W load: control-looking token: 50 '<|tool_response>' was not control-type; this is probably a bug in the model. its type will be overridden 0.00.926.166 W load: control-looking token: 1 '<eos>' was not control-type; this is probably a bug in the model. its type will be overridden 0.00.958.649 W load: special_eog_ids contains '<|tool_response>', removing '</s>' token from EOG list 0.00.990.550 W llama_context: n_ctx_seq (512) > n_ctx_train (0) -- possible training context overflow 2 -> '<bos>' 238865 -> '강' 237534 -> '아' 237308 -> '지'
$ /mnt/Downloads/llama-b10488/llama-tokenize -m gemma-4-E4B-it-Q4_K_M.gguf -p 송아지 0.00.895.230 W load: control-looking token: 212 '' was not control-type; this is probably a bug in the model. its type will be overridden 0.00.895.969 W load: control-looking token: 50 '<|tool_response>' was not control-type; this is probably a bug in the model. its type will be overridden 0.00.906.303 W load: control-looking token: 1 '' was not control-type; this is probably a bug in the model. its type will be overridden 0.00.939.847 W load: special_eog_ids contains '<|tool_response>', removing '' token from EOG list 0.00.972.088 W llama_context: n_ctx_seq (512) > n_ctx_train (0) -- possible training context overflow 2 -> '' 239917 -> '송' 237534 -> '아' 237308 -> '지'
/mnt/Downloads/llama-b10488/llama-tokenize -m Qwen3.8-27B-UD-IQ2_XXS.gguf -p 마이크로소프트 0.00.773.458 W llama_context: n_ctx_seq (512) > n_ctx_train (0) -- possible training context overflow 148763 -> '마' 156847 -> '이크' 16869 -> '로' 216243 -> '소프트'
$ /mnt/Downloads/llama-b10488/llama-tokenize -m Qwen3.8-27B-UD-IQ2_XXS.gguf -p 대한민국 0.00.728.852 W llama_context: n_ctx_seq (512) > n_ctx_train (0) -- possible training context overflow 178031 -> '대한' 161266 -> '민국'
$ /mnt/Downloads/llama-b10488/llama-tokenize -m Qwen3.8-27B-UD-IQ2_XXS.gguf -p 강아지 0.00.774.480 W llama_context: n_ctx_seq (512) > n_ctx_train (0) -- possible training context overflow 152029 -> '강' 51181 -> '아' 20673 -> '지'
$ /mnt/Downloads/llama-b10488/llama-tokenize -m Qwen3.8-27B-UD-IQ2_XXS.gguf -p 송아지 0.00.769.448 W llama_context: n_ctx_seq (512) > n_ctx_train (0) -- possible training context overflow 150491 -> '송' 51181 -> '아' 20673 -> '지'
build : b10488-9d77fa172 model : base42m-q4_0.gguf ftype : Q4_0 modalities : text
available commands: /exit or Ctrl+C stop or exit /regen regenerate the last response /clear clear the chat history /read <file> add a text file /glob <pattern> add text files using globbing pattern
> 세조대호아잉 >>>>>>>>>>>>>>>>>>>>>>>>>>>)의 순서로는 이례적으로, 그리고 이 작품이 나중의 문학적 삶의 방식에서 영감을 받은 것으로 평가된다.
[ Prompt: 213.6 t/s | Generation: 197.3 t/s ]
> 대한민국 >>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>)와 >>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>>)이다.
[ Prompt: 257.0 t/s | Generation: 56.8 t/s ]
> 이다 0.16.540.856 E srv send_error: task id = 330, error: request (513 tokens) exceeds the available context size (512 tokens), try increasing it Error: request (513 tokens) exceeds the available context size (512 tokens), try increasing it
[ Prompt: 0.0 t/s | Generation: 0.0 t/s ]
> /clear Chat history cleared.
> 오오 >>>를 통해 “Linkword (rock tit)”의 "아름다운"을 언급하는 것을 고려하면, "아름다운"이라는 용어는 “Linkword”에서 유래한 것이다. 이것은 "Linkword"와 같은 다른 형태의 조합을 포함하는 단어로, 이는 “Linkword”를 의미하는 단어로, 이는 영어로 "Linkword"를 의미하며, 이는 ‘Linkword(newing)’와 같은 축약형에 해당하지 않는다. 이 단어들은 주로 영어 단어에서와 같이 사용되었지만, Linkword가 다른 단어들과 유사하게 자주 인용되는 것은 아니다. Linkword에서의 q-word는 Linkword의 한 구절에 나타난다. Linkword의 다른 구절은 Linkword를 ‘Linkword’에서 q-word와 같은 의미를 가진 단어로, Linkword에서 vii를 ‘Linkword’에서 q-word가 된다. Linkword는 Linkword의 q-word를 의미한다. Linkword의 다른 구절에는 Linkword가 q-word와 같이 Linkword의 q-word의 첫 번째 구절과 두 번째 구절을 공유한다. Linkword의 첫 번째 구절에는 Linkword가 q-word에서의 Linkword의 첫 번째 구절에서 q-word를 나타낸다. Linkword의 첫 번째 구절에는 Linkword의 "Linkword"가 포함되어 있다. Linkword가 q-word를 의미한다. Linkword의 첫 번째 구절은 Linkword가 q-word를 의미한다. Linkword는 Linkword가 q-word를 나타낸다. Linkword는 Linkword와 Linkword가 모두 q-word를 나타낸다. Linkword는 Linkword의 첫 번째 구절에서, Linkword는 Linkword가 q-word를 나타낸다. Linkword의 마지막 구절은 Linkword의 q-word를 나타낸다. Linkword는 Linkword와 Linkword가 q-
- 코퍼스: 책 한 권씩이 쌓인 도서관에 해당합니다. - 토큰: 그 책을 낱말 카드로 잘라 놓은 것에 해당합니다. - 크기 표시: 코퍼스의 크기는 글자 수나 토큰 수 둘 다로 말합니다. 우리 코퍼스는 5.56억 글자이고, 이 토크나이저로는 2.43억 토큰입니다. 그래서 "코퍼스가 2.43억 토큰"이라고 말하는 건 "토큰으로 센 크기"라는 뜻입니다. - 학습에 들어가는 형태: 모델은 글을 직접 읽지 못하고 토큰 번호만 받습니다.
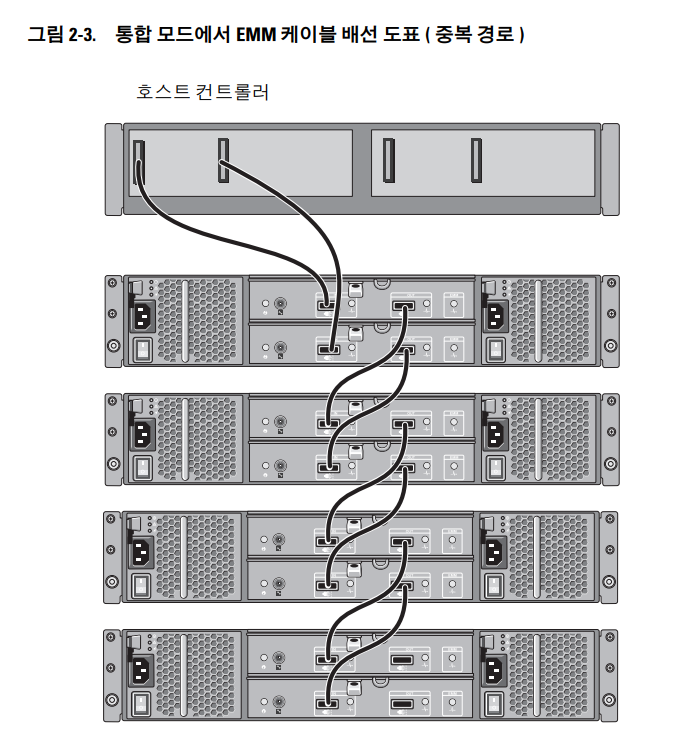
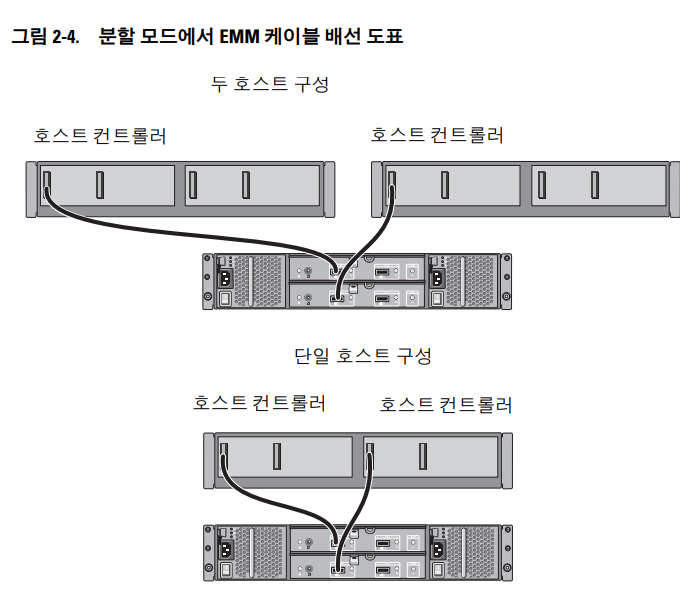
구성 다음 구성 중 하나를 지원합니다 . • 인클로저 당 12개의 하드 드라이브에 직접 연결이 가능한 단일 모드 . – 컨트롤러 포트 당 총 48개의 하드 드라이브와 컨트롤러 당 96 개의 하드 드라이브를 위한 최대 4 개의 데이지 체인 저장장치 인클로저 . – 총 192 개의 드라이브를 위한 서버 당 최대 2 개의 듀얼 포트 컨트롤러 구성 . – 중복 경로 연결성은 각각의 하드 드라이브에 대한 중복 데이터 경로를 제공합니다 . 중복 경로 구성은 컨트롤러 당 총 48개의 하드 드라이브와 서버 당 92 개의하드 드라이브를 위해 최대 4 개의 데이지 체인 저장장치 인클로저를 지원합니다 . • 듀얼 EMMs 가 내장된 분할 모드는 드라이브 0 ~ 5 에 대해 직접 연결 기능을 제공하며 드라이브 6 ~ 11 에 대해 개별적인 직접 연결 기능을 제공합니다 . 분할모드 구성은 중복
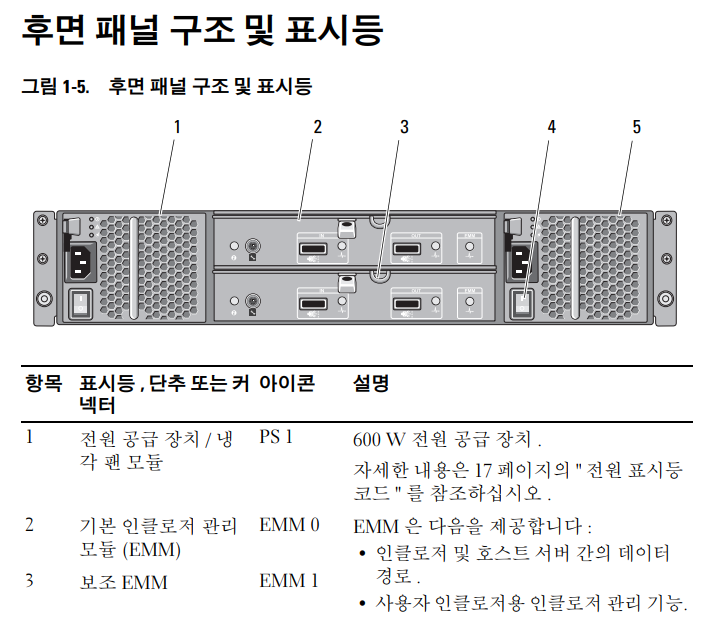
후면 패널 커넥터 SAS 커넥터 (EMM 당 ) • 호스트 연결용 SAS 입력 (IN) 커넥터 1 개 • 추가 인클로저 확장용 SAS 출력 (OUT) 커넥터 1 개 주 : SAS 커넥터는 SFF-8086/SFF-8088 을 준수합니다 . 직렬 커넥터 (EMM 당 )6 핀 UART 미니 DIN 커넥터 1 개 주 : 공학적 용도 전용