ai가 해줘도 직접인가..?
아무튼 중2 개발자가 직접 만든 한글 LLM 이란거에 한달뒤에 늦게 발동해서 해보는데
[링크 : https://news.hada.io/topic?id=32792]
[링크 :https://github.com/seoan1024/korean-llm-v3]
[링크 : https://github.com/seoan1024/Korean-llm-v4]
막상 해보고 나니 무슨 의미가 있나 싶기도 하고
일단 gemma4-e4b / gemma4-31B / qwen3.8 등에서 llama-tokenizer 로 돌려보니
생각외로 큰 차이는 없었고(내가 한국어사전을 이용해서 한거라 제법 단어로 될 줄 알았더니 의외로 안되서 실망)
결국 중요한건 학습셋 인가 라는 결론만..
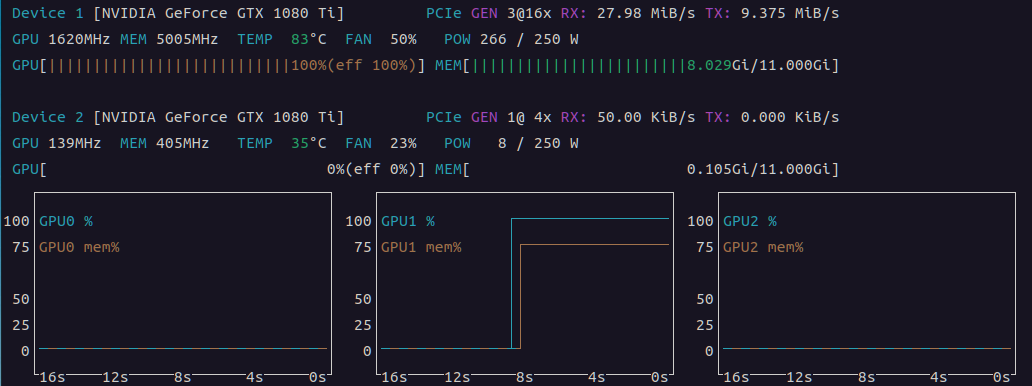
1080ti 1개로
8시간 에 2000 epoch 학습
양자화 하지 않을 경우 163MB / q4_0 양자화시 28MB
생각보다 메모리 많이 먹고 있다.
토큰은 우리말사전을 기준으로 추출
학습셋은 한국어 위키피디아.
+
| 크기 ┌────────────────────────┬─────────────┐ │ 구성요소 │ 파라미터 수 │ ├────────────────────────┼─────────────┤ │ 임베딩 (32,448 × 512) │ 16,613,376 │ ├────────────────────────┼─────────────┤ │ 트랜스포머 블록 × 8층 │ 25,690,112 │ ├────────────────────────┼─────────────┤ │ 정규화(RMSNorm) × 17개 │ 9,216 │ ├────────────────────────┼─────────────┤ │ 합계 │ ≈ 42.3M │ └────────────────────────┴─────────────┘ 출력층은 별도 파라미터 없이 임베딩 행렬을 그대로 재사용합니다(tied embedding) — 입력 임베딩과 출력 확률 계산이 같은 32,448×512 행렬을 공유해서 파라미터를 아낍니다. 블록 1개(3,211,264개) 안에서는 어텐션이 1,048,576개, SwiGLU가 2,162,688개로 FFN이 어텐션의 약 2배 차지합니다. 이건 LLaMA류의 전형적인 비율입니다. 입력 토큰 id → 임베딩(emb) : id → 512차원 벡터 → [블록 × 8] x = x + Attention(RMSNorm(x)) : 잔차 연결 1 x = x + SwiGLU(RMSNorm(x)) : 잔차 연결 2 → 최종 RMSNorm(norm) → emb.weight.T 와 곱함 : 512차원 → 32,448개 토큰 확률(logits) - RMSNorm: LayerNorm의 경량 버전. 평균을 빼지 않고 제곱평균으로만 스케일을 맞춥니다(x * rsqrt(mean(x²))). 학습 가능한 스케일 벡터 w 하나만 가집니다(bias 없음). LLaMA/Gemma 계열이 공통으로 쓰는 방식이고, 일반 LayerNorm보다 계산이 싸고 안정적입니다. - rope(x, cos, sin): 회전 위치 인코딩(RoPE). Q, K 벡터를 절반씩 잘라(x1, x2) 2D 회전을 적용해서 "이 토큰이 몇 번째 위치인가"를 벡터 자체에 새겨 넣습니다. 별도의 위치 임베딩 파라미터가 없고, 상대적 거리 정보가 자연스럽게 학습됩니다. - Attention: - qkv 선형층 하나로 Q/K/V를 한 번에 계산(512 → 1536) - 8개 헤드로 나눠 각각 RoPE 적용 - F.scaled_dot_product_attention(..., is_causal=True) — PyTorch 내장 함수로, 이 안에서 Flash Attention 커널이 자동 선택됩니다(가능한 하드웨어에서). causal=True라 미래 토큰을 보지 못하게 마스킹됩니다. - GQA/MQA 없이 순수 MHA(8쿼리헤드=8키헤드) — 이전에 설명드렸듯 이 모델 크기·문맥길이(512)에서는 KV 캐시 절감 이득보다 품질 손실이 더 클 수 있어 안 씁니다. - 마지막에 o 선형층으로 다시 섞음. - SwiGLU: 게이트 달린 FFN. w13이 두 벡터(a, b)를 동시에 뽑고, silu(a) * b로 게이팅한 뒤 w2로 다시 512차원으로 축소. 일반 ReLU-FFN보다 표현력이 좋다고 알려져 LLaMA/PaLM 계열이 표준으로 씁니다. - Block: 위 둘을 Pre-Norm 방식(정규화 먼저, 그다음 서브레이어)으로 감싸고 잔차 연결. GPT-2식 Post-Norm보다 학습이 안정적입니다. - 초기화: 일반 가중치는 std=0.02 정규분포. 단, 각 블록의 "잔차에 더해지는 마지막 선형층"(attn.o, mlp.w2)은 0.02/sqrt(2*8)로 더 작게 초기화합니다 — 층이 깊어질수록 잔차 누적으로 분산이 커지는 걸 막는 GPT-2/nanoGPT식 트릭입니다. - forward: 학습 시 targets를 주면 다음 토큰 예측 교차엔트로피 손실까지 한 번에 계산. logits.view(-1, V) 형태로 펴서 전체 배치·시퀀스 위치를 한꺼번에 손실 계산합니다. - generate: 자기회귀 생성 루프. - 매 스텝 마지막 block_size(512) 토큰만 잘라서 forward (문맥 길이 제한) - temperature로 확률 분포를 누그러뜨리고, top_k로 후보를 40개로 제한한 뒤 multinomial로 샘플링 (확률적 생성 — 어제 보여드린 samples.txt가 이 방식) - eos_id를 만나면 조기 종료 (SFT용으로 <|end|> id를 넘길 수 있게 만들어둔 파라미터) - 제가 별도로 검증할 때 쓴 "탐욕적(top_k=1 상당)" 생성은 이 함수를 안 쓰고 argmax로 직접 만든 스크립트였습니다 — 결정적 결과 확인용. 설정값 (Config) ┌──────────────────────────────────┬────────────────────────────────────────────────────────────────────────────────────────────────┐ │ 값 │ 의미 │ ├──────────────────────────────────┼────────────────────────────────────────────────────────────────────────────────────────────────┤ │ vocab_size=32448 │ 실제 토큰 32,408개를 GPU 효율을 위해 64의 배수로 패딩 (GGUF 내보낼 때는 실제 개수로 다시 자름) │ ├──────────────────────────────────┼────────────────────────────────────────────────────────────────────────────────────────────────┤ │ block_size=512 │ 한 번에 볼 수 있는 최대 토큰 수 (문맥 길이) — llama-cli 대화 모드에서 넘치면 에러 나던 원인 │ ├──────────────────────────────────┼────────────────────────────────────────────────────────────────────────────────────────────────┤ │ n_layer=8, n_head=8, d_model=512 │ 8층, 헤드당 64차원(512/8) │ ├──────────────────────────────────┼────────────────────────────────────────────────────────────────────────────────────────────────┤ │ ffn_hidden=1408 │ SwiGLU 내부 확장 차원 │ ├──────────────────────────────────┼────────────────────────────────────────────────────────────────────────────────────────────────┤ │ rope_base=10000.0 │ RoPE 회전 주파수 기준값 (LLaMA 기본값과 동일) │ └──────────────────────────────────┴────────────────────────────────────────────────────────────────────────────────────────────────┘ 총평: 이 모델은 아키텍처 자체는 실제 LLaMA/Mistral과 완전히 동일한 축소판입니다(RMSNorm+RoPE+SwiGLU+tied embedding+causal MHA). 차이는 오직 규모(8층/512차원 vs 수십층/수천차원)와 GQA 유무뿐이라, 여기서 배운 구조 지식은 실제 대형 오픈소스 모델을 읽을 때 그대로 적용됩니다. |
암만봐도 이거랑 유사한 단어들이 많이 나온단 말이지..
[링크 : https://github.com/seoan1024/Korean-llm-v4]
아키텍쳐상 계통이 같은 듯?
| ● 네, 구조상 아키텍처 계열이 같습니다 — 다만 규모와 세부 구현은 상당히 다릅니다. 비교 ┌────────────────────┬───────────────────────────────────────────┬──────────────────────────────────────────────────────────────────────┐ │ 항목 │ 이 프로젝트(seoan1024) │ llm-ko(여기) │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 정규화/위치/활성화 │ RMSNorm + RoPE + SwiGLU │ 동일 │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 임베딩 공유 │ O │ O │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 파라미터 수 │ 약 1.09B │ 약 42.3M (25배 작음) │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 레이어/은닉/헤드 │ 20층 / 1920차원 / 10헤드 │ 8층 / 512차원 / 8헤드 │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 토크나이저 │ 남의 것 재사용 (beomi/Llama-3-Open-Ko-8B) │ 직접 학습(SentencePiece Unigram, 32,408개) │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 정밀도 │ BF16 │ fp32 (우리 GPU는 Pascal이라 fp16/bf16 이득 없음, 이전에 실측 확인함) │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 학습 단계 │ pretrain → SFT 2단계 │ 동일 구조 (base → sft, pipeline.sh) │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 라이선스 │ GPL-3.0 │ 목표: Apache-2.0/MIT │ ├────────────────────┼───────────────────────────────────────────┼──────────────────────────────────────────────────────────────────────┤ │ 요구 하드웨어 │ RTX 3060 이상, RAM 64GB, 1TB NVMe │ GTX 1080 Ti ×2 (훨씬 낮은 사양 지향) │ └────────────────────┴───────────────────────────────────────────┴──────────────────────────────────────────────────────────────────────┘ 왜 비슷해 보이는가 RMSNorm+RoPE+SwiGLU+임베딩공유 조합은 LLaMA가 2023년에 공개한 이후 사실상 업계 표준이 됐습니다(Mistral, Gemma, Qwen 등도 동일 계열). 이건 특정 프로젝트의 독창적 아이디어가 아니라 공개된 논문·아키텍처를 다들 그대로 쓰는 것이라, "닮았다"기보다는 같은 표준 설계를 각자 구현한 것에 가깝습니다. 2단계(pretrain→SFT) 구조도 요즘 오픈소스 LLM 학습의 사실상 정석 흐름이고요. 실제 차이가 나는 지점은: - 규모: 저쪽은 1B급(RTX 4090 권장)까지 키웠고, 우리는 1080 Ti 2장으로 42M급을 목표로 함 - 토크나이저: 저쪽은 이미 있는 8B짜리 모델의 토크나이저를 가져다 씀. 우리는 처음부터 직접 학습 — 이게 우리 프로젝트에서 꽤 공들인 부분이라 차별점입니다 - 라이선스: 여기가 중요한데, 저쪽은 GPL-3.0입니다. 우리는 Apache/MIT를 목표로 하고 있으니 저 저장소의 코드를 참고해서 베끼면 안 됩니다(GPL은 파생물도 GPL로 강제). 지금까지 우리 코드는 제가 직접 작성했고 저 저장소를 본 적도 없으니 문제없지만, 앞으로도 저기 코드를 보고 옮겨오는 건 피해야 합니다 — 순수 아키텍처 개념(RMSNorm 수식 등)을 참고하는 것 자체는 문제없지만(아이디어는 저작권 대상이 아님), 코드 구현체를 그대로 가져오면 라이선스가 섞입니다. 요약하면: "같은 요리법(LLaMA 스타일)으로 만든 다른 레스토랑" 정도입니다. 걱정하실 만한 건 라이선스뿐이고, 그것도 우리가 독립적으로 작성한 코드라 문제없습니다. |
'모종의 음모 > ai 프로그램' 카테고리의 다른 글
| 직접만든 LLM .. part 2 (0) | 2026.09.23 |
|---|---|
| wikimatrix (0) | 2026.09.22 |
| llama-tokenize (0) | 2026.09.22 |
| llama-cli /clear (0) | 2026.09.22 |
| llama-simple (0) | 2026.09.22 |


