두번째 녀석이 4,1로 떠서 pcie1.0 x4 lane으로 작동하고 있었는데
| $ nvidia-smi --query-gpu=pcie.link.width.current,pcie.link.gen.current pcie.link.width.current, pcie.link.gen.current 16, 3 4, 1 |
bios 에서 pcie3.0으로 설정해서 3.0 으로라도 잡히게 일단 하고 시도
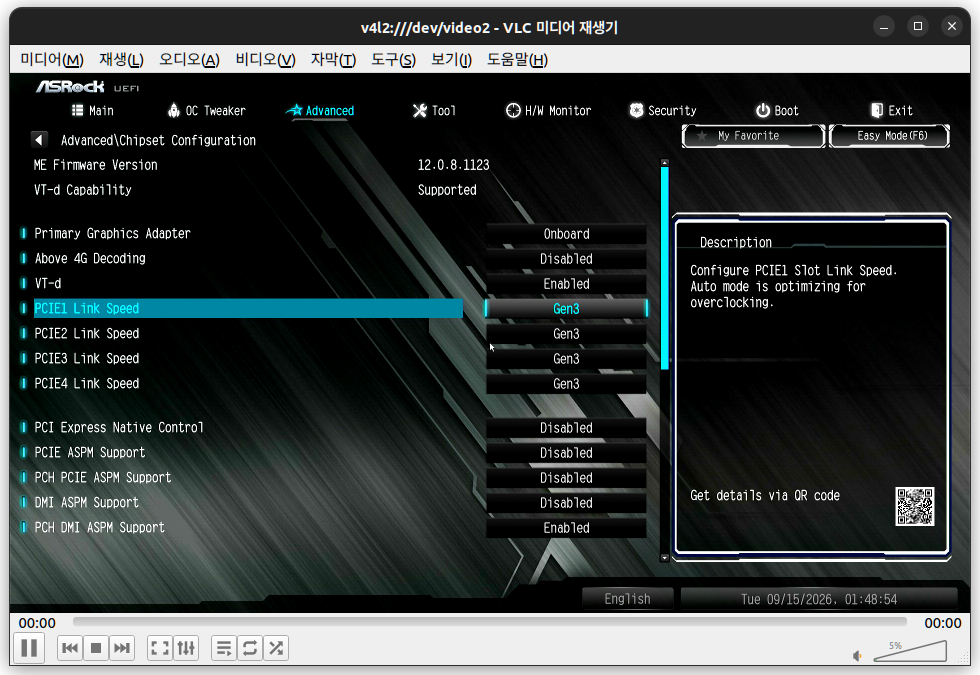
그냥은 1로 뜨고(절전모드) 부하를 걸어주면 이렇게 올라온다.
| $ nvidia-smi --query-gpu=pcie.link.width.current,pcie.link.gen.current pcie.link.width.current, pcie.link.gen.current 16, 3 4, 3 |
llama.cpp 에서 -sm row, tensor 모두 실패.
layer만 가능한데 돌려보니 이전에 pcie1.0 일것으로 추정되는 때랑 차이가 없다.
| $ ../../llama-b10488/llama-cli -m gemma-4-31B-it-UD-Q2_K_XL.gguf -sm layer > 안녕? [ Prompt: 1.3 t/s | Generation: 12.0 t/s ] > 너에 대해 설명해줘 [ Prompt: 20.4 t/s | Generation: 11.8 t/s ] > 파이썬으로 셀레니움을 통해 웹을 서칭하고 텍스트만 추출하고 makrdown 으로 변환후 md 파일과 pdf로 저장하는 기능을 구현해줘 [ Prompt: 30.6 t/s | Generation: 11.5 t/s ] 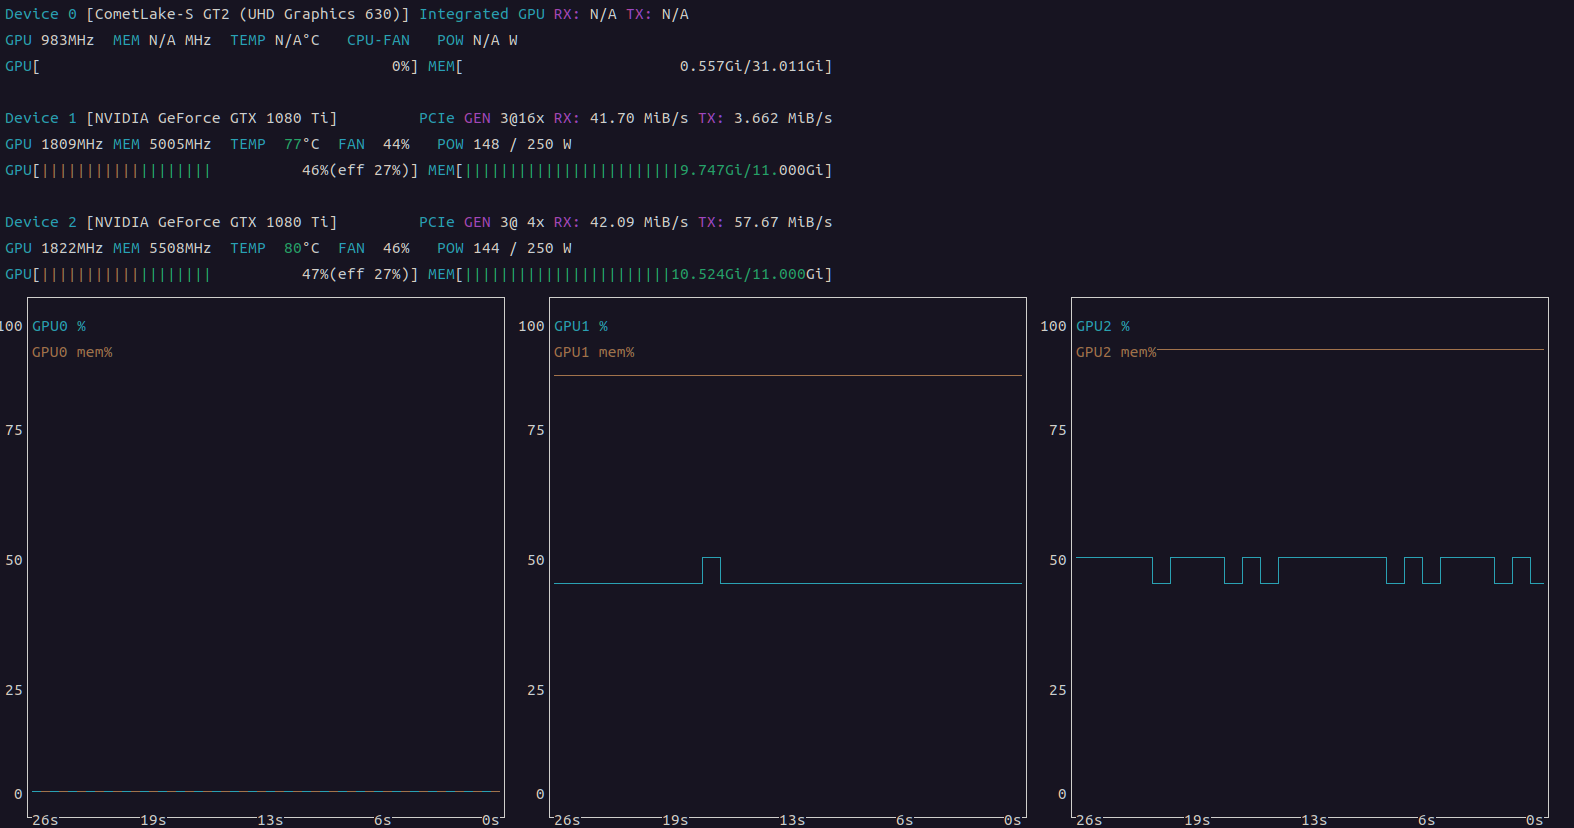 |
이건 이전 기록.. 흐음..
| $ ../../llama-b9692/llama-cli -m ./gemma-4-31B-it-UD-Q2_K_XL.gguf 안녕? [ Prompt: 8.9 t/s | Generation: 12.2 t/s ] 너에 대해 설명해줘 [ Prompt: 33.3 t/s | Generation: 11.8 t/s ] 파이썬으로 셀레니움을 통해 웹을 서칭하고 텍스트만 추출하고 makrdown 으로 변환후 md 파일과 pdf로 저장하는 기능을 구현해줘 [ Prompt: 36.1 t/s | Generation: 11.4 t/s ] |
2026.07.30 - [모종의 음모/ai 프로그램] - llama.cpp / 1080 ti 11GB * 2/ gemma4-31B
'모종의 음모 > ai 프로그램' 카테고리의 다른 글
| auroc - area under the ROC curve (0) | 2026.09.01 |
|---|---|
| llama.cpp vulkan / intel uhd 630 (0) | 2026.09.01 |
| stable diffusion model 이란 (0) | 2026.08.28 |
| llama swap matrix (0) | 2026.08.28 |
| claude code with local LLM (0) | 2026.08.24 |


