모종의 음모/ai 프로그램
프로그래밍도 할 줄 아는 local LLM 만들기.. part 2?
구차니
2026. 10. 20. 10:26
그냥 클로드가 다해줘버리는 느낌이라 모르겠다 ㅋㅋㅋㅋ
아무튼, 이번 실험의 주제는 model이 우선이냐, sft가 우선이냐 인데
결론만 보면 "결과물의 품질은 model이 우선이다, 하지만 사용자 체감은 model 이 동등할 경우 sft가 크다." 이다
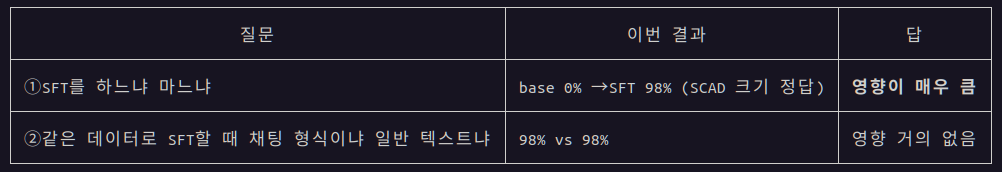
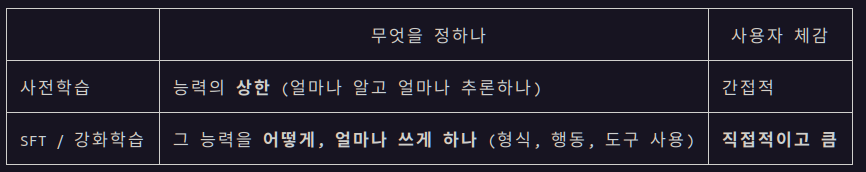
정작 학습된 모델도 openSCAD로 내가 원하는대로 작동을 만들어낼 순 없긴한데..
얼마나 더 많은 자료와 gpu를 때려박아야 작동할까 -ㅁ-?
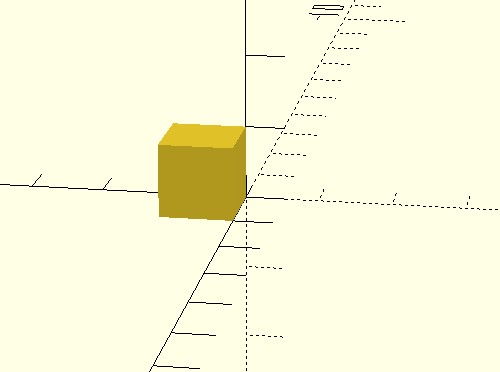
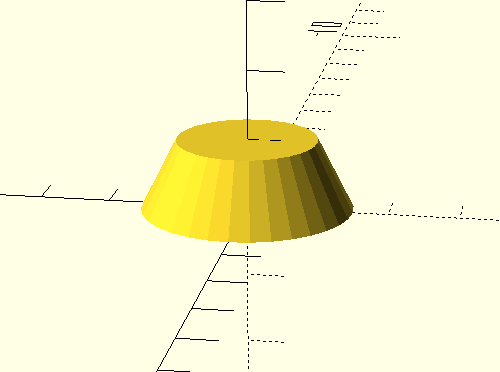
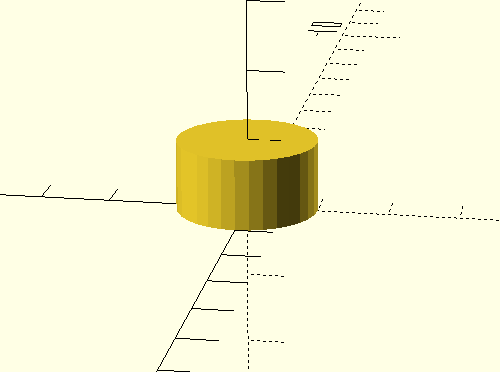
아래는 그나마 그려지는 예. 그 와중에 python 으로 하라는데 sft 영향을 강하게 받아서 openSCAD로 해버린다.
| > cube each 1m cube([1,1,1]); [ Prompt: 9.9 t/s | Generation: 40.3 t/s ] |
 |
| > donut cylinder (h=1, r1=1.5, r2, $fn=32); [ Prompt: 155.9 t/s | Generation: 39.6 t/s ] |
 |
| > rectangle in python cylinder (h=1, r1=1, r2, $fn=32); [ Prompt: 177.6 t/s | Generation: 42.0 t/s ] |
 |
일단 이번 테스트 요약하면
1. model의 크기, 정보량이 결국은 결과의 품질을 보장한다.
2. epoch가 높진 않다. 1~2 epoch. 그래서 미친듯이 원본 데이터를 수집하는 거군.. ai 업체들이 톤 단위로 책 사들이는 이유..
3. sft는 생각외로 사용자 체감이 크고, 본 학습 시간보다 sft는 빠르게 끝난다. 좋게 보면 학습에 대한 효율이 좋다.